
IMAGE → TEXT · OCR
Ảnh thành văn bản — OCR riêng tư
Trích xuất chữ từ ảnh và ảnh chụp màn hình. Sao chép hoặc tải tệp văn bản, tất cả ngay trong trình duyệt.
Thêm ảnh
JPG · PNG · WebP · BMP
Bạn cũng có thể dán ảnh chụp màn hình bằng Ctrl+V hoặc ⌘V. Nếu không truy cập được bảng nhớ tạm, hãy chọn tệp ảnh.
Tối đa 20 ảnh, mỗi tệp 20 MB, tổng cộng 100 MB và mỗi ảnh 40 megapixel.
Chọn ngôn ngữ trong ảnh. Trích xuất lại sẽ thay thế kết quả trước đó.
Văn bản của bạn
Văn bản trích xuất sẽ xuất hiện tại đây. Thêm ảnh để bắt đầu.
Phù hợp nhất với chữ in rõ nét và ảnh chụp màn hình. Chữ viết tay và bố cục phức tạp có thể cho kết quả kém. Hãy kiểm tra và chỉnh sửa trước khi sử dụng.
Ảnh và văn bản luôn ở trên thiết bị của bạn. Công cụ nhận dạng và tệp ngôn ngữ được tải từ ItsyTools. Chỉ tệp ngôn ngữ được lưu vào bộ nhớ đệm; công cụ này không lưu ảnh hoặc văn bản của bạn.
Trích xuất và kiểm tra văn bản từ ảnh
Dùng OCR bảo vệ quyền riêng tư để chuyển ảnh chụp màn hình, ảnh chụp hoặc trang quét thành văn bản có thể sao chép hay lưu. Nhận dạng chạy trên thiết bị của bạn. Công cụ hoạt động tốt nhất với chữ in rõ ràng; kết quả là bản chép lại cần kiểm tra, không đảm bảo rằng mọi ký tự, bảng hay thứ tự đọc đều đúng.
Từng bước thực hiện
- Thêm ảnh JPG, PNG, WebP hoặc BMP, hoặc dán ảnh khi trình duyệt cho phép truy cập bảng nhớ tạm. Chọn ngôn ngữ của văn bản trong ảnh; thiết lập này tách biệt với ngôn ngữ giao diện của trang web.
- Bắt đầu nhận dạng và đợi trong khi bộ máy được tải và xử lý ảnh. Giữ thẻ trình duyệt mở. Chọn từng kết quả trong lô và so sánh tên, ngày, số tiền và dấu câu với ảnh nguồn.
- Sửa văn bản đã nhận dạng trước khi sao chép hoặc tải xuống. Lưu một kết quả dưới dạng văn bản hoặc dùng tải văn bản kết hợp cho các tệp đã hoàn tất. Giữ ảnh gốc đến khi bạn kiểm tra xong bản chép lại.
Cài đặt và giới hạn
- Ngôn ngữ nhận dạng và tải
- Chọn mô hình khớp với chữ in. Khi dùng lần đầu, trang web cung cấp bộ máy OCR và mô hình ngôn ngữ cho trình duyệt; lượt tải xuống đó không phải là tải ảnh của bạn lên. Tài nguyên đã lưu trong bộ nhớ đệm không đảm bảo mọi ngôn ngữ đều hoạt động ngoại tuyến.
- Giới hạn đầu vào
- Thêm tối đa 20 ảnh, mỗi ảnh tối đa 20.000.000 byte và tổng cộng 100.000.000 byte. Ảnh không được vượt quá 40.000.000 điểm ảnh hoặc 20.000 điểm ảnh ở bất kỳ chiều nào. Tệp PDF không được chấp nhận trực tiếp; hãy dùng PDF sang ảnh trước.
- Độ chính xác và thay đổi kích thước
- Trước khi nhận dạng, ảnh lớn được thu nhỏ xuống tối đa 3.200 điểm ảnh ở cạnh dài nhất và khoảng 8.000.000 điểm ảnh. Cắt bỏ vùng không liên quan và dùng văn bản thẳng, sắc nét, có độ tương phản cao. Chữ viết tay, ánh sáng chói, cột và bảng có thể cho kết quả không đáng tin cậy.
Ví dụ thực hành
Tải ocr-sample.png và chọn tiếng Anh làm ngôn ngữ nhận dạng. Chạy OCR và so sánh bản chép lại với ocr-expected.txt; mẫu có 3 dòng chữ in rõ ràng.
Tải các tệp ví dụ
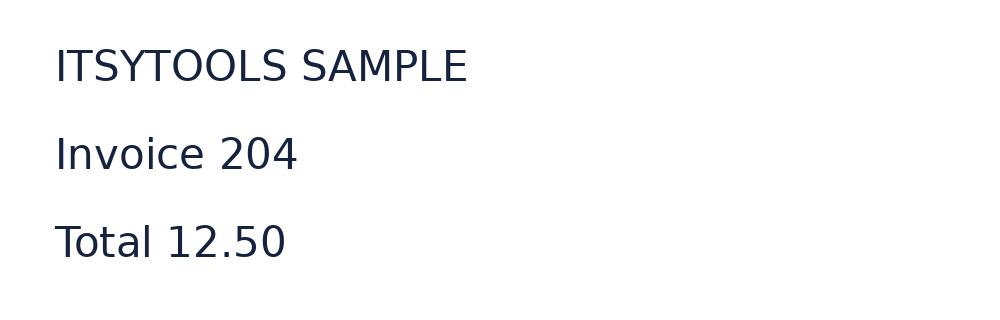
Kết quả dự kiến
ITSYTOOLS SAMPLE
Invoice 204
Total 12.50
Kiểm tra rằng có ITSYTOOLS SAMPLE, Invoice 204 và Total 12.50, và các con số khớp nhau. Khoảng trắng và ngắt dòng có thể khác. Sửa mọi khác biệt trước khi dùng văn bản trong tài liệu khác.
Câu hỏi và khắc phục sự cố
Tại sao chữ cái hoặc số bị sai?
OCR suy đoán từ các điểm ảnh nhìn thấy. Hãy thử bản quét rõ hơn, cắt sát văn bản hơn và chọn đúng ngôn ngữ. Luôn kiểm tra các ký tự giống nhau như O và 0, nhất là trong số tài khoản và số tiền.
Tại sao văn bản sai thứ tự?
Cột, biểu mẫu và bảng có thể làm sai thứ tự đọc. Nhận dạng từng phần đã cắt và tự dựng lại cấu trúc. Tải văn bản thuần không giữ các ô bảng tính hay bố cục trang gốc.
Tại sao nhận dạng dừng hoặc không bắt đầu?
Tải mô hình, khởi động luồng xử lý hoặc ảnh tốn nhiều bộ nhớ có thể thất bại. Kiểm tra kết nối cho lượt tải bộ máy ban đầu, thử ảnh hoặc lô nhỏ hơn rồi thử lại. Các kết quả đã hoàn tất có thể vẫn sẵn dùng sau khi hủy.