
IMAGE → TEXT · OCR
تصویر سے متن — نجی OCR
تصاویر اور اسکرین شاٹس سے متن نکالیں۔ اسے کاپی کریں یا متنی فائل ڈاؤن لوڈ کریں، سب کچھ اپنے براؤزر میں۔
تصاویر شامل کریں
JPG · PNG · WebP · BMP
آپ Ctrl+V یا ⌘V سے اسکرین شاٹ بھی پیسٹ کر سکتے ہیں۔ کلپ بورڈ دستیاب نہ ہو تو تصویر کی فائل منتخب کریں۔
زیادہ سے زیادہ 20 تصاویر، ہر فائل 20 MB، کل 100 MB اور ہر تصویر 40 میگاپکسل۔
تصاویر میں موجود متن کی زبان منتخب کریں۔ دوبارہ متن نکالنے سے پچھلے نتائج بدل جائیں گے۔
آپ کا متن
نکالا گیا متن یہاں نظر آئے گا۔ شروع کرنے کے لیے تصویر شامل کریں۔
صاف چھپے ہوئے متن اور اسکرین شاٹس کے لیے بہتر ہے۔ ہاتھ کی لکھائی اور پیچیدہ ترتیب کے نتائج اچھے نہ ہوں۔ استعمال سے پہلے نتیجہ دیکھیں اور درست کریں۔
تصاویر اور متن آپ کے آلے پر رہتے ہیں۔ شناختی ٹولز اور زبان کی فائلیں ItsyTools سے لوڈ ہوتی ہیں۔ صرف زبان کی فائلیں کیش میں محفوظ ہوتی ہیں؛ یہ ٹول آپ کی تصاویر یا متن محفوظ نہیں کرتا۔
تصویر سے متن نکالیں اور جانچیں
رازداری برقرار رکھنے والے OCR سے اسکرین شاٹ، تصویر یا اسکین شدہ صفحے کو ایسے متن میں بدلیں جسے آپ نقل یا محفوظ کر سکیں۔ شناخت آپ کے آلے پر ہوتی ہے۔ صاف چھپے ہوئے متن کے ساتھ بہترین کام ہوتا ہے؛ نتیجہ جانچنے کے لیے نقل شدہ متن ہے، ہر حرف، جدول یا پڑھنے کی ترتیب درست ہونے کی ضمانت نہیں۔
مرحلہ وار رہنمائی
- JPG، PNG، WebP یا BMP تصاویر شامل کریں، یا جب براؤزر کلپ بورڈ تک رسائی دے تو تصویر پیسٹ کریں۔ تصویر کے متن کی زبان منتخب کریں؛ یہ ترتیب ویب سائٹ کے انٹرفیس کی زبان سے الگ ہے۔
- شناخت شروع کریں اور انجن لوڈ ہونے اور تصاویر کی پروسیسنگ کا انتظار کریں۔ ٹیب کھلا رکھیں۔ مجموعے کا ہر نتیجہ منتخب کر کے نام، تاریخیں، رقوم اور رموزِ اوقاف اصل تصویر سے ملائیں۔
- شناخت شدہ متن کو نقل یا ڈاؤن لوڈ کرنے سے پہلے درست کریں۔ ایک نتیجہ متن کے طور پر محفوظ کریں یا مکمل شدہ فائلوں کے لیے مشترکہ متن ڈاؤن لوڈ کریں۔ اصل تصاویر اس وقت تک رکھیں جب تک متن جانچ نہ لیں۔
ترتیبات اور حدود
- شناخت کی زبان اور لوڈنگ
- چھپے ہوئے متن کے مطابق ماڈل منتخب کریں۔ پہلی بار استعمال پر سائٹ OCR انجن اور زبان کا ماڈل آپ کے براؤزر کو فراہم کرتی ہے؛ یہ ڈاؤن لوڈ آپ کی تصاویر کا اپ لوڈ نہیں ہے۔ کیش شدہ اثاثے ہر زبان کے آف لائن کام کرنے کی ضمانت نہیں دیتے۔
- ان پٹ کی حدود
- زیادہ سے زیادہ 20 تصاویر شامل کریں، ہر ایک 20,000,000 بائٹس تک اور کل 100,000,000 بائٹس تک۔ تصویر 40,000,000 پکسلز یا کسی سمت میں 20,000 پکسلز سے زیادہ نہیں ہونی چاہیے۔ PDF فائلیں براہِ راست قبول نہیں؛ پہلے PDF سے تصویر استعمال کریں۔
- درستگی اور سائز میں تبدیلی
- شناخت سے پہلے بڑی تصاویر کا سب سے لمبا کنارہ زیادہ سے زیادہ 3,200 پکسلز اور کل سائز تقریباً 8,000,000 پکسلز تک گھٹایا جاتا ہے۔ غیر متعلقہ حصے کاٹیں اور سیدھا، واضح اور زیادہ تضاد والا متن استعمال کریں۔ ہاتھ کی لکھائی، چمک، کالم اور جدول غیر معتبر نتائج دے سکتے ہیں۔
عملی مثال
ocr-sample.png ڈاؤن لوڈ کریں اور شناخت کی زبان انگریزی منتخب کریں۔ OCR چلائیں اور متن کو ocr-expected.txt سے ملائیں؛ نمونے میں واضح چھپے ہوئے متن کی 3 سطریں ہیں۔
مثال کی فائلیں ڈاؤن لوڈ کریں
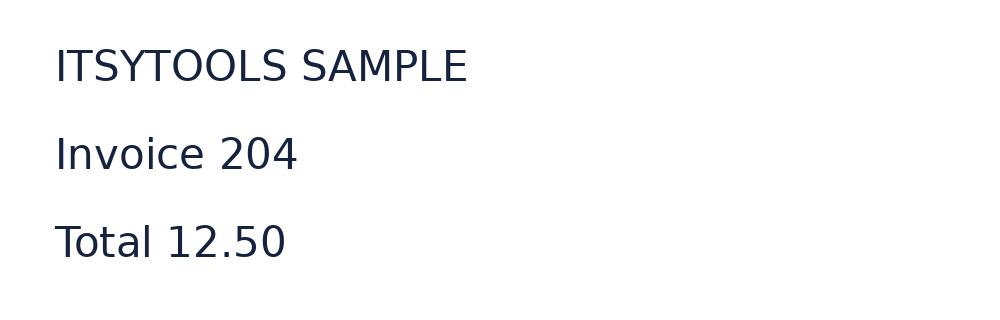
متوقع نتیجہ
ITSYTOOLS SAMPLE
Invoice 204
Total 12.50
جانچیں کہ ITSYTOOLS SAMPLE، Invoice 204 اور Total 12.50 موجود ہیں اور اعداد ملتے ہیں۔ خالی جگہیں اور سطر کے وقفے مختلف ہو سکتے ہیں۔ متن کسی دوسرے دستاویز میں استعمال کرنے سے پہلے ہر فرق درست کریں۔
سوالات اور مسائل کا حل
حروف یا اعداد غلط کیوں ہیں؟
OCR نظر آنے والے پکسلز سے اندازہ لگاتا ہے۔ زیادہ واضح اسکین آزمائیں، متن کے قریب تصویر کاٹیں اور درست زبان منتخب کریں۔ O اور 0 جیسے ملتے جلتے حروف ہمیشہ جانچیں، خاص طور پر اکاؤنٹ نمبروں اور رقوم میں۔
متن کی ترتیب غلط کیوں ہے؟
کالم، فارم اور جدول پڑھنے کی ترتیب کو الجھا سکتے ہیں۔ ایک وقت میں ایک کاٹا ہوا حصہ شناخت کریں اور ساخت خود دوبارہ بنائیں۔ سادہ متن کا ڈاؤن لوڈ اسپریڈشیٹ کے خانے یا اصل صفحے کی ترتیب محفوظ نہیں کرتا۔
شناخت رک کیوں جاتی ہے یا شروع کیوں نہیں ہوتی؟
ماڈل کا ڈاؤن لوڈ، ورکر کا آغاز یا زیادہ میموری لینے والی تصویر ناکام ہو سکتی ہے۔ ابتدائی انجن ڈاؤن لوڈ کے لیے کنکشن جانچیں، چھوٹی تصویر یا مجموعہ آزمائیں اور دوبارہ کوشش کریں۔ منسوخی کے بعد بھی مکمل شدہ نتائج دستیاب رہ سکتے ہیں۔