
IMAGE → TEXT · OCR
चित्र से टेक्स्ट — निजी OCR
फ़ोटो और स्क्रीनशॉट से टेक्स्ट निकालें। उसे कॉपी करें या टेक्स्ट फ़ाइल डाउनलोड करें, सब कुछ आपके ब्राउज़र में।
चित्र जोड़ें
JPG · PNG · WebP · BMP
आप Ctrl+V या ⌘V से स्क्रीनशॉट भी पेस्ट कर सकते हैं। क्लिपबोर्ड उपलब्ध न हो तो चित्र फ़ाइल चुनें।
अधिकतम 20 चित्र, प्रति फ़ाइल 20 MB, कुल 100 MB और प्रति चित्र 40 मेगापिक्सेल।
चित्रों में मौजूद टेक्स्ट की भाषा चुनें। दोबारा निकालने पर पुराने नतीजे बदल जाएंगे।
आपका टेक्स्ट
निकाला गया टेक्स्ट यहाँ दिखेगा। शुरू करने के लिए एक चित्र जोड़ें।
साफ़ छपे टेक्स्ट और स्क्रीनशॉट के लिए सबसे अच्छा। लिखावट और जटिल लेआउट के नतीजे अच्छे न भी हों। इस्तेमाल से पहले नतीजे की जाँच और संपादन करें।
चित्र और टेक्स्ट आपके डिवाइस पर रहते हैं। पहचान टूल और भाषा फ़ाइलें ItsyTools से लोड होती हैं। केवल भाषा फ़ाइलें कैश होती हैं; यह टूल आपके चित्र या टेक्स्ट सहेजता नहीं है।
तस्वीर से टेक्स्ट निकालें और जाँचें
निजता बनाए रखने वाले OCR से स्क्रीनशॉट, फ़ोटो या स्कैन किए पेज को ऐसे टेक्स्ट में बदलें जिसे आप कॉपी या सहेज सकें। पहचान आपके डिवाइस पर होती है। यह साफ़ छपे हुए टेक्स्ट के साथ सबसे अच्छा काम करता है; परिणाम जाँचने के लिए एक प्रतिलेख है, हर अक्षर, तालिका या पढ़ने का क्रम सही होने की गारंटी नहीं।
चरण-दर-चरण
- JPG, PNG, WebP या BMP तस्वीरें जोड़ें, या ब्राउज़र क्लिपबोर्ड की अनुमति दे तो तस्वीर पेस्ट करें। तस्वीर के टेक्स्ट की भाषा चुनें; यह सेटिंग वेबसाइट की इंटरफ़ेस भाषा से अलग है।
- पहचान शुरू करें और इंजन लोड होने तथा तस्वीरों के संसाधित होने की प्रतीक्षा करें। टैब खुला रखें। बैच में हर परिणाम चुनकर नाम, तारीख़, रकम और विराम चिह्न मूल तस्वीर से मिलाएँ।
- पहचाना गया टेक्स्ट कॉपी या डाउनलोड करने से पहले ठीक करें। एक परिणाम टेक्स्ट के रूप में सहेजें या पूरी हुई फ़ाइलों का संयुक्त टेक्स्ट डाउनलोड करें। प्रतिलेख जाँचने तक मूल तस्वीरें रखें।
सेटिंग और सीमाएँ
- पहचान की भाषा और लोडिंग
- छपे हुए टेक्स्ट के अनुसार मॉडल चुनें। पहली बार उपयोग पर साइट OCR इंजन और भाषा मॉडल आपके ब्राउज़र को भेजती है; इस डाउनलोड में आपकी तस्वीरें अपलोड नहीं होतीं। कैश किए गए संसाधन हर भाषा के ऑफ़लाइन काम करने की गारंटी नहीं देते।
- इनपुट की सीमाएँ
- अधिकतम 20 तस्वीरें जोड़ें, हर एक अधिकतम 20,000,000 बाइट और कुल आकार अधिकतम 100,000,000 बाइट हो। तस्वीर में 40,000,000 पिक्सेल से अधिक या किसी किनारे पर 20,000 पिक्सेल से अधिक नहीं होने चाहिए। PDF फ़ाइलें सीधे स्वीकार नहीं होतीं; पहले PDF से तस्वीर उपयोग करें।
- सटीकता और आकार बदलना
- पहचान से पहले बड़ी तस्वीरें घटाकर सबसे लंबे किनारे पर अधिकतम 3,200 पिक्सेल और लगभग 8,000,000 पिक्सेल की बनाई जाती हैं। गैरज़रूरी हिस्से काटें और सीधा, स्पष्ट, उच्च कंट्रास्ट वाला टेक्स्ट उपयोग करें। हस्तलेखन, चमक, कॉलम और तालिकाएँ अविश्वसनीय परिणाम दे सकते हैं।
हल किया हुआ उदाहरण
ocr-sample.png डाउनलोड करें और पहचान की भाषा अंग्रेज़ी चुनें। OCR चलाएँ और प्रतिलेख को ocr-expected.txt से मिलाएँ; नमूने में साफ़ छपे टेक्स्ट की 3 पंक्तियाँ हैं।
उदाहरण की फ़ाइलें डाउनलोड करें
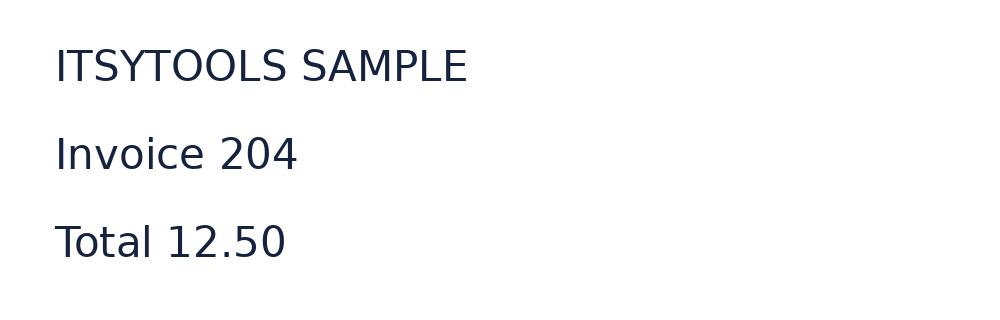
अपेक्षित परिणाम
ITSYTOOLS SAMPLE
Invoice 204
Total 12.50
जाँचें कि ITSYTOOLS SAMPLE, Invoice 204 और Total 12.50 मौजूद हैं और संख्याएँ सही हैं। खाली जगह और पंक्ति विराम अलग हो सकते हैं। किसी दूसरे दस्तावेज़ में टेक्स्ट उपयोग करने से पहले हर अंतर ठीक करें।
सवाल और समस्या समाधान
अक्षर या संख्याएँ गलत क्यों हैं?
OCR दिखाई देने वाले पिक्सेल से अनुमान लगाता है। साफ़ स्कैन आज़माएँ, टेक्स्ट के करीब क्रॉप करें और सही भाषा चुनें। O और 0 जैसे समान दिखने वाले चिह्न हमेशा जाँचें, खासकर खाता संख्या और रकम में।
टेक्स्ट गलत क्रम में क्यों है?
कॉलम, फ़ॉर्म और तालिकाएँ पढ़ने का क्रम उलझा सकते हैं। एक बार में एक क्रॉप किए हिस्से की पहचान करें और संरचना ख़ुद दोबारा बनाएँ। साधारण टेक्स्ट डाउनलोड स्प्रेडशीट के सेल या मूल पेज का लेआउट सुरक्षित नहीं रखता।
पहचान क्यों रुकती है या शुरू क्यों नहीं होती?
मॉडल डाउनलोड, वर्कर का शुरू होना या ज़्यादा मेमोरी लेने वाली तस्वीर विफल हो सकती है। शुरुआती इंजन डाउनलोड के लिए कनेक्शन जाँचें, छोटी तस्वीर या छोटा बैच आज़माएँ और फिर कोशिश करें। रद्द करने के बाद भी पूरे हुए परिणाम उपलब्ध रह सकते हैं।