
IMAGE → TEXT · OCR
Изображение в текст — приватный OCR
Распознавайте текст на фото и снимках экрана. Копируйте его или скачивайте текстовый файл — всё в браузере.
Добавить изображения
JPG · PNG · WebP · BMP
Можно также вставить снимок экрана с помощью Ctrl+V или ⌘V. Если буфер обмена недоступен, выберите файл изображения.
До 20 изображений, 20 МБ на файл, всего 100 МБ и 40 мегапикселей на изображение.
Выберите язык на изображениях. Повторное распознавание заменяет результаты.
Ваш текст
Распознанный текст появится здесь. Добавьте изображение, чтобы начать.
Лучше всего для чёткого печатного текста и снимков экрана. Рукописный текст и сложная вёрстка могут распознаваться плохо. Проверьте и отредактируйте результат перед использованием.
Изображения и текст остаются на вашем устройстве. Средства распознавания и языковые файлы загружаются с ItsyTools. Кешируются только языковые файлы; инструмент не сохраняет ваши изображения или текст.
Извлеките и проверьте текст из изображения
Используйте OCR с сохранением конфиденциальности, чтобы преобразовать снимок экрана, фотографию или сканированную страницу в текст, который можно скопировать или сохранить. Распознавание работает на вашем устройстве. Лучше всего оно справляется с чётким печатным текстом; результат — это распознанный текст для проверки, а не гарантия правильности каждого символа, таблицы или порядка чтения.
Пошаговая инструкция
- Добавьте изображения JPG, PNG, WebP или BMP либо вставьте изображение, если браузер разрешает доступ к буферу обмена. Выберите язык текста на изображении; эта настройка не зависит от языка интерфейса сайта.
- Запустите распознавание и подождите, пока движок загрузится и обработает изображения. Оставьте вкладку открытой. Выберите каждый результат в пакете и сравните названия, даты, суммы и знаки препинания с исходным изображением.
- Исправьте распознанный текст перед копированием или скачиванием. Сохраните один результат как текст или скачайте объединённый текст завершённых файлов. Храните исходные изображения, пока не проверите распознанный текст.
Настройки и ограничения
- Язык распознавания и загрузка
- Выберите модель, соответствующую печатному тексту. При первом использовании сайт передаёт движок OCR и языковую модель в ваш браузер; эта загрузка не означает отправку ваших изображений. Кешированные ресурсы не гарантируют, что каждый язык будет работать без интернета.
- Ограничения входных данных
- Добавьте не более 20 изображений размером до 20 000 000 байт каждое и до 100 000 000 байт всего. Изображение не должно превышать 40 000 000 пикселей или 20 000 пикселей по любой стороне. Файлы PDF не принимаются напрямую; сначала используйте PDF в изображение.
- Точность и изменение размеров
- Перед распознаванием большие изображения уменьшаются максимум до 3 200 пикселей по самой длинной стороне и примерно 8 000 000 пикселей. Обрежьте ненужные области и используйте ровный, чёткий, высококонтрастный текст. Рукописный текст, блики, колонки и таблицы могут давать ненадёжные результаты.
Разбор примера
Скачайте ocr-sample.png и выберите английский как язык распознавания. Запустите OCR и сравните распознанный текст с ocr-expected.txt; образец содержит 3 строки чёткого печатного текста.
Скачать файлы примера
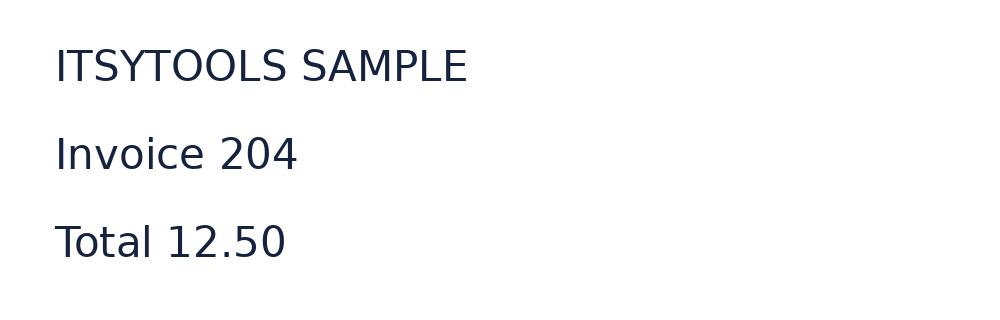
Ожидаемый результат
ITSYTOOLS SAMPLE
Invoice 204
Total 12.50
Проверьте наличие ITSYTOOLS SAMPLE, Invoice 204 и Total 12.50 и соответствие чисел. Пробельные символы и разрывы строк могут отличаться. Исправьте все различия перед использованием текста в другом документе.
Вопросы и устранение неполадок
Почему буквы или числа неправильные?
OCR определяет символы по видимым пикселям. Попробуйте более чёткий скан, обрежьте изображение ближе к тексту и выберите правильный язык. Всегда проверяйте похожие символы, например O и 0, особенно в номерах счетов и суммах.
Почему текст идёт в неправильном порядке?
Колонки, формы и таблицы могут нарушать порядок чтения. Распознавайте по одному обрезанному фрагменту и самостоятельно восстановите структуру. Скачивание обычного текста не сохраняет ячейки электронной таблицы или исходный макет страницы.
Почему распознавание останавливается или не запускается?
Загрузка модели, запуск рабочего процесса или изображение, требующее много памяти, могут привести к ошибке. Проверьте соединение для первоначальной загрузки движка, попробуйте меньшее изображение или пакет и повторите попытку. Завершённые результаты могут оставаться доступными после отмены.