
IMAGE → TEXT · OCR
이미지를 텍스트로 — 개인정보 보호 OCR
사진과 스크린샷에서 텍스트를 추출하세요. 복사하거나 텍스트 파일로 다운로드하는 모든 작업이 브라우저에서 이루어집니다.
이미지 추가
JPG · PNG · WebP · BMP
Ctrl+V 또는 ⌘V로 스크린샷을 붙여넣을 수도 있습니다. 클립보드를 사용할 수 없으면 이미지 파일을 선택하세요.
최대 20개 이미지, 파일당 20 MB, 총 100 MB, 이미지당 4천만 화소까지 지원합니다.
이미지 속 텍스트의 언어를 선택하세요. 다시 추출하면 기존 결과가 바뀝니다.
추출한 텍스트
추출한 텍스트가 여기에 표시됩니다. 이미지를 추가해 시작하세요.
선명한 인쇄 텍스트와 스크린샷에 적합합니다. 손글씨와 복잡한 레이아웃은 잘 인식되지 않을 수 있습니다. 사용 전에 결과를 확인하고 수정하세요.
이미지와 텍스트는 기기에만 남습니다. 인식 도구와 언어 파일은 ItsyTools에서 불러옵니다. 언어 파일만 캐시되며 이 도구는 이미지나 텍스트를 저장하지 않습니다.
이미지에서 텍스트를 추출하고 확인하기
개인정보를 보호하는 OCR을 사용하여 스크린샷, 사진 또는 스캔한 페이지를 복사하거나 저장할 수 있는 텍스트로 변환하세요. 인식은 기기에서 실행됩니다. 선명한 인쇄 텍스트에서 가장 잘 작동합니다. 결과는 검토가 필요한 전사본이며, 모든 문자, 표 또는 읽기 순서가 정확하다는 보장은 아닙니다.
단계별 사용 방법
- JPG, PNG, WebP 또는 BMP 이미지를 추가하거나 브라우저가 클립보드 접근을 허용하면 이미지를 붙여 넣으세요. 이미지 속 텍스트의 언어를 선택하세요. 이 설정은 웹사이트의 인터페이스 언어와 별개입니다.
- 인식을 시작하고 엔진이 로드되어 이미지를 처리할 때까지 기다리세요. 탭을 열어 두세요. 일괄 처리의 각 결과를 선택하여 이름, 날짜, 금액 및 문장 부호를 원본 이미지와 비교하세요.
- 복사하거나 다운로드하기 전에 인식된 텍스트를 수정하세요. 결과 하나를 텍스트로 저장하거나 완료된 파일의 텍스트를 합쳐 다운로드할 수 있습니다. 전사본을 확인할 때까지 원본 이미지를 보관하세요.
설정 및 제한
- 인식 언어 및 로딩
- 인쇄된 텍스트에 맞는 모델을 선택하세요. 처음 사용할 때 사이트가 OCR 엔진과 언어 모델을 브라우저로 전달합니다. 이 다운로드는 이미지를 업로드하는 것이 아닙니다. 자원이 캐시되어 있어도 모든 언어가 오프라인에서 작동한다는 보장은 없습니다.
- 입력 제한
- 최대 20 이미지를 추가할 수 있으며, 각 이미지 최대 20,000,000 바이트, 전체 최대 100,000,000 바이트입니다. 이미지는 40,000,000 픽셀을, 각 변은 20,000 픽셀을 초과할 수 없습니다. PDF 파일은 직접 허용되지 않으므로 먼저 ‘PDF를 이미지로’를 사용하세요.
- 정확도 및 크기 조정
- 인식 전에 큰 이미지는 가장 긴 변이 최대 3,200 픽셀, 전체 픽셀 수가 약 8,000,000이 되도록 축소됩니다. 불필요한 부분을 잘라 내고 기울지 않은 선명한 고대비 텍스트를 사용하세요. 손글씨, 빛 반사, 여러 단 및 표는 결과가 부정확할 수 있습니다.
실습 예제
ocr-sample.png를 다운로드하고 인식 언어로 영어를 선택하세요. OCR을 실행하고 전사본을 ocr-expected.txt와 비교하세요. 예제에는 선명한 인쇄 텍스트가 3줄 있습니다.
예제 파일 다운로드
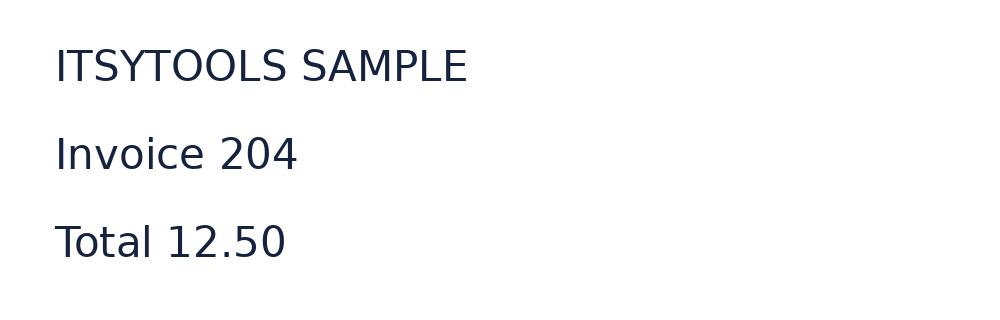
예상 결과
ITSYTOOLS SAMPLE
Invoice 204
Total 12.50
ITSYTOOLS SAMPLE, Invoice 204 및 Total 12.50이 있고 숫자가 일치하는지 확인하세요. 공백과 줄바꿈은 다를 수 있습니다. 다른 문서에서 텍스트를 사용하기 전에 차이를 모두 수정하세요.
질문 및 문제 해결
문자나 숫자가 틀리는 이유는 무엇인가요?
OCR은 보이는 픽셀을 바탕으로 추정합니다. 더 선명한 스캔을 사용하고 텍스트에 가깝게 잘라 내며 올바른 언어를 선택하세요. 특히 계좌 번호와 금액에서 O와 0처럼 비슷한 문자를 반드시 확인하세요.
텍스트 순서가 잘못된 이유는 무엇인가요?
여러 단, 양식 및 표는 읽기 순서를 혼동시킬 수 있습니다. 잘라 낸 부분을 한 번에 하나씩 인식하고 구조는 직접 재구성하세요. 일반 텍스트 다운로드는 스프레드시트 셀이나 원본 페이지 레이아웃을 유지하지 않습니다.
인식이 멈추거나 시작되지 않는 이유는 무엇인가요?
모델 다운로드, 워커 시작 또는 메모리를 많이 사용하는 이미지 처리에 실패할 수 있습니다. 최초 엔진 다운로드를 위한 연결을 확인하고 더 작은 이미지나 일괄 처리로 다시 시도하세요. 취소한 뒤에도 완료된 결과는 계속 이용할 수 있습니다.